Caméras de profondeur et position 3D dans l’apprentissage robotique : résultats et pratique
Ce que DP3, RVT-2, 3D Diffuser Actor et les politiques spatiales plus récentes révèlent sur la profondeur, l’état du robot et la généralisation, et comment les évaluer sur un système réel.
1 851 motsEnviron 9 min de lecture
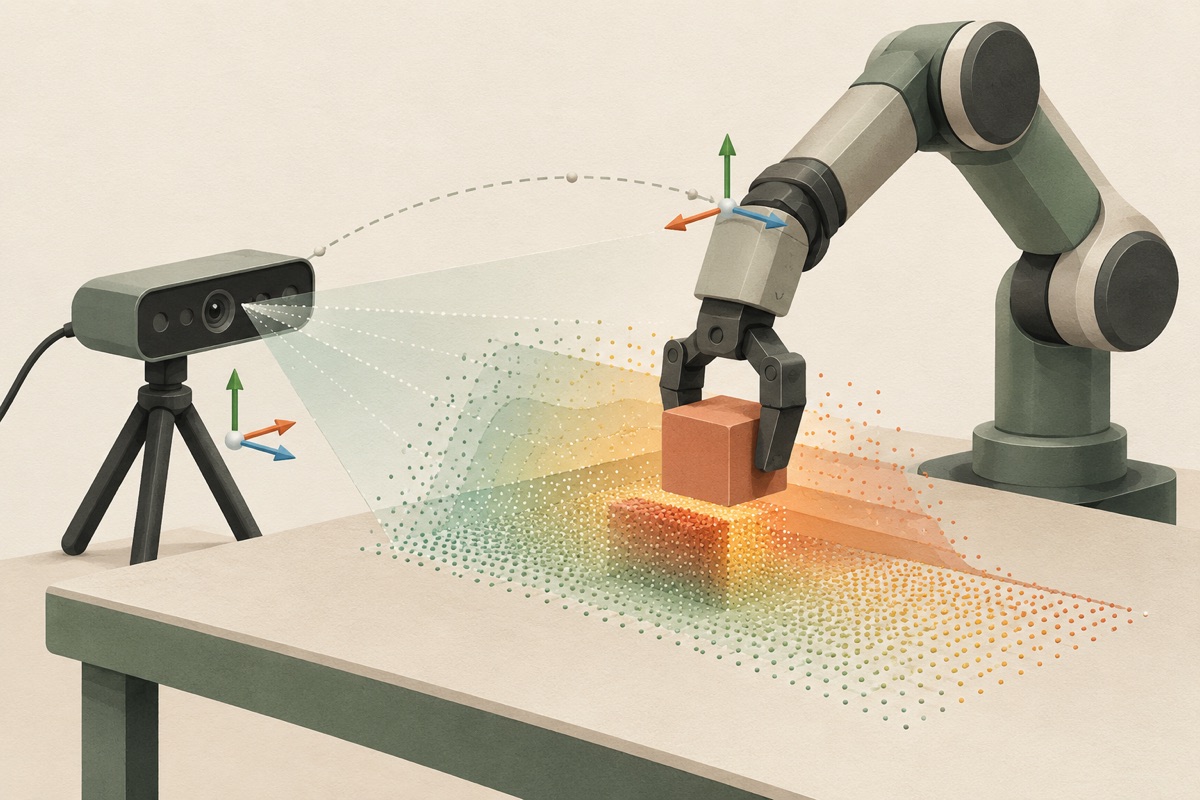
Les caméras de profondeur peuvent améliorer les politiques de commande des robots en facilitant la représentation des distances et des relations spatiales. Les résultats les plus convaincants portent sur une chaîne complète : une géométrie mesurée ou apprise, des repères cohérents, un modèle adapté et un contrôleur capable d’exécuter ses prédictions. Un canal de profondeur supplémentaire ne constitue pas, à lui seul, une amélioration fiable.
Ce dossier de recherche examine une sélection d’articles de 2023 à 2026 et des ressources de mise en œuvre vérifiées le 30 octobre 2026. Les résultats ci-dessous sont ceux rapportés par les auteurs ; Dentry ne les a pas reproduits. Cette sélection constitue un guide de lecture ciblé, et non une revue systématique ou un classement entre différents bancs d’essai.
Que signifie « information de position » ?
Plusieurs signaux distincts sont souvent regroupés sous cette appellation :
- Géométrie de la scène : une carte de profondeur fournit une profondeur pour chaque pixel ; un modèle de caméra étalonné transforme les pixels et leur profondeur en points tridimensionnels.
- Transformations entre repères : la pose de la caméra relie ces points à la base du robot ou à une carte. La transformation d’une caméra montée au poignet évolue lorsque le bras se déplace.
- État du robot : les positions articulaires, l’ouverture de la pince ou la pose actuelle de l’effecteur décrivent le robot lui-même. Les politiques n’utilisent pas toutes le même sous-ensemble de ces données.
- Encodage positionnel du modèle : des coordonnées ou des décalages relatifs indiquent à un modèle d’attention les relations entre les caractéristiques de la scène et les actions candidates. Il s’agit d’un choix de représentation, pas d’un capteur supplémentaire.
Selon notre interprétation, distinguer explicitement ces notions facilite le diagnostic des expériences : une image de profondeur précise ne peut pas compenser une transformation erronée entre la caméra et le robot.
DP3 : un nuage de points aide davantage qu’un canal d’image supplémentaire
Dans la comparaison en simulation de DP3 portant sur 72 tâches, le taux de réussite moyen atteint 74,4 %, contre 59,8 % pour Diffusion Policy avec des images RGB, soit un écart de 14,6 points de pourcentage à partir des valeurs arrondies publiées. DP3 conditionne son générateur d’actions sur une représentation compacte du nuage de points et sur les poses du robot. [1]
Son étude d’ablation des représentations sur six tâches est particulièrement instructive : les nuages de points atteignent 78,3 %, les images RGB 40,7 %, les images de profondeur 32,0 % et les images RGB-D 34,7 %. Ajouter simplement la profondeur à une entrée de type image n’a pas permis de reproduire le résultat des nuages de points. Les encodeurs diffèrent également : cette expérience évalue donc la chaîne de représentation, plutôt que d’isoler l’effet causal d’un capteur. [1]
Pour une équipe de développement logiciel, la question utile est de savoir comment la géométrie est préservée au cours du prétraitement et de l’encodage. Le dépôt officiel de DP3 fournit du code et des liens vers les données pour explorer cette question. [7]
3D Diffuser Actor : la position relative compte aussi
Dans l’étude d’ablation sur RLBench présentée dans l’article, une variante 2D atteint 47,0 %, une variante 3D avec attention absolue 71,3 %, et le modèle complet 81,3 %. Ce dernier gagne respectivement 34,3 et 10,0 points de pourcentage par rapport à ces variantes. La variante 2D agrège aussi les caractéristiques à l’intérieur de chaque vue : ces résultats portent donc conjointement sur la représentation et la fusion. [2]
Les caractéristiques de la scène, la position actuelle de l’effecteur et les actions candidates interagissent dans une représentation spatiale commune. Dans le dispositif robotique réel, un planificateur de mouvement exécute les poses prédites. Cette organisation distingue utilement l’apprentissage d’une cible de l’exécution du mouvement permettant de l’atteindre. [2]
RVT-2 : un placement précis exige des détails géométriques locaux
RVT-2 affine une cible grossière à l’aide d’une vue virtuelle plus rapprochée de la région pertinente du nuage de points. Sur RLBench, il obtient 81,4 %, contre 62,9 % pour RVT. Les deux méthodes utilisent déjà des observations tridimensionnelles ; l’écart de 18,5 points ne constitue donc pas une comparaison entre caméra de profondeur et caméra RGB. [3]
Pour trois tâches réelles de précision, dont l’insertion d’une cheville et d’une fiche, la moyenne publiée passe de 33,3 % à 53,3 %. Chaque tâche ne comporte que dix démonstrations et dix essais d’évaluation. Ces résultats étayent un prototype de recherche, pas une affirmation selon laquelle l’insertion serait prête pour la production. Les auteurs évoquent aussi le retour d’effort comme moyen de traiter les erreurs de contact restantes. Le code et les modèles sont disponibles dans le dépôt officiel de RVT. [3] [8]
La généralisation peut progresser sans améliorer les résultats sur les tâches familières
L’article sur iDP3 apporte une nuance importante. Dans un test de prise et de dépose dans une nouvelle scène, iDP3 réussit 9 essais sur 10, contre 2 sur 10 pour Diffusion Policy avec des images RGB et un encodeur R3M affiné. Cependant, la référence RGB obtient de meilleurs résultats dans une expérience distincte menée dans les conditions d’entraînement avec peu de données. Ces expériences utilisent des protocoles d’évaluation différents et ne doivent pas être fusionnées en un unique taux de réussite mis en avant. [4]
iDP3 utilise une géométrie exprimée dans le repère de la caméra, issue d’une caméra de profondeur LiDAR RealSense L515 montée sur la tête, qu’il combine avec les positions articulaires. Dans le dispositif de manipulation humanoïde présenté, la partie inférieure du corps est soutenue et immobile ; ces résultats ne démontrent pas la marche autonome ni la capacité à fournir des services domestiques. La leçon pratique est d’évaluer séparément les changements de scène et la précision sur les tâches familières. [4]
GeoAlign : la profondeur peut servir à l’entraînement sans caméra de profondeur lors de l’exécution
GeoAlign, une étude de 2026, utilise une supervision RGB-D lors d’une phase de post-entraînement géométrique. À l’exécution, sa politique reçoit des images RGB, du langage et l’état du robot, sans carte de profondeur mesurée ou prédite en entrée. Cette méthode constitue donc une option de déploiement distincte des politiques fondées sur des nuages de points, qui exigent des observations de profondeur à chaque étape. [5]
Sur huit tâches réelles avec ALOHA et 160 essais, la référence utilisant uniquement le RGB réussit 104 fois, soit 65,0 % ; GeoAlign réussit 126 fois, soit 78,8 % selon le chiffre publié. L’écart est d’environ 13,8 points de pourcentage. Le système utilise aussi un jeu de données de post-entraînement géométrique comprenant 580 960 paires d’images RGB-D : l’amélioration ne peut donc pas être attribuée à la seule architecture. Lors de la vérification effectuée pour cet article, le projet annonçait encore la publication prochaine du code. [5] [13]
C’est une piste de recherche pour les équipes qui disposent déjà de jeux de données robotiques RGB. Il ne s’agit pas encore d’un remplacement prêt à installer pour une politique disponible utilisant la profondeur.
RISE : le matériel et la collecte des données changent le résultat
RISE utilise un nuage de points issu d’une seule vue et prédit les actions dans le repère de la caméra ; sa politique n’ajoute pas d’entrées proprioceptives séparées. Dans leur discussion pratique, les auteurs rapportent des difficultés à reproduire DP3 avec leur propre caméra et leur protocole de démonstration. Le bruit de profondeur, les choix de zone de travail et les trajectoires de démonstration influencent tous le transfert. [6]
Le dépôt officiel fournit des instructions d’étalonnage et d’évaluation sur robot réel. Le code et les données sont proposés sous licence CC BY-NC-SA 4.0 ; un usage commercial impose donc de vérifier les autorisations applicables, plutôt que de supposer que tout dépôt de recherche public le permet. [9]
Des applications au-delà de la politique apprise
Pour la manipulation sur table, les applications les plus directes sont la localisation des cibles de préhension, le déplacement d’objets vers des positions définies dans l’espace et l’affinement du placement près d’un logement ou d’un réceptacle. Les études ci-dessus présentent des exemples de ces capacités, avec des robots et des conditions d’évaluation différents.
La navigation peut bénéficier de la profondeur sans réentraîner un grand modèle d’action. nvblox de NVIDIA reçoit des observations de profondeur, les paramètres de la caméra et une transformation de pose, construit une carte tridimensionnelle et en déduit des informations de distance aux obstacles pour la planification des trajectoires. Il s’agit d’un composant de géométrie et de planification, pas d’une preuve qu’un modèle de langage devient plus performant du seul fait de recevoir de la profondeur. [10]
HomeRobot illustre le problème d’intégration plus large : son banc d’essai de manipulation mobile à vocabulaire ouvert associe la recherche d’objets, la navigation, la préhension et la dépose. Ses méthodes de référence initiales atteignaient 20 % de réussite en conditions réelles. C’est un résultat historique à l’échelle d’un système, et non une limite actuelle ou une ablation isolant la profondeur. [11]
Un plan d’évaluation pratique
Les étapes suivantes constituent notre proposition de méthode d’ingénierie, et non une expérience déjà réalisée par Dentry.
- Choisir une tâche bien délimitée. Commencer par la prise et la dépose sur une surface de travail fixe, et définir la réussite avant de recueillir des démonstrations. Comptabiliser séparément l’avancement partiel et la réussite de la tâche complète.
- Établir une référence géométrique exploitable. Vérifier la profondeur aux distances de travail et sur les matériaux réellement utilisés. Examiner les pixels manquants, l’alignement RGB-profondeur, les horodatages, les paramètres intrinsèques de la caméra et la transformation entre caméra et robot. Les conseils de réglage du fabricant constituent un point de départ utile, mais ne remplacent pas les mesures sur l’installation. [12]
- Enregistrer des observations et des actions synchronisées. Conserver le RGB brut, la profondeur, l’étalonnage, l’état du robot et les horodatages. Expliciter le repère et les unités ; une cible exprimée dans le repère de la caméra n’est pas interchangeable avec une cible exprimée dans celui de la base du robot.
- Comparer des variantes contrôlées. Utiliser, autant que possible, les mêmes démonstrations, le même budget d’entraînement, la même distribution de tâches et le même contrôleur. Comparer RGB plus état, RGB-D plus état et représentation en nuage de points plus état. Indiquer clairement lorsqu’un encodeur ou un modèle préentraîné change également.
- Tester les changements qui comptent en dehors du jeu d’entraînement. Déplacer les objets, modifier les arrière-plans et l’éclairage, changer le point de vue, introduire des occultations et évaluer d’autres exemplaires d’objets. Pour l’insertion ou la manipulation avec compliance, tester la stratégie de commande du contact autant que la localisation visuelle.
- Mesurer toute la boucle. Présenter le taux de réussite des tâches complètes avec le nombre d’essais et l’incertitude, l’erreur de placement, les interventions, les collisions, la latence d’inférence et le temps nécessaire à l’exécution. Conserver les limites de mouvement, la vérification des collisions et l’arrêt d’urgence dans la couche d’exécution.
Un premier déploiement intéressant serait une politique reproductible de manipulation sur table, avec une chaîne RGB-D étalonnée et un contrôleur existant. Une plateforme mobile peut, quant à elle, tirer immédiatement parti d’une carte fondée sur la profondeur. Les méthodes qui n’utilisent que le RGB à l’exécution, comme GeoAlign, méritent d’être suivies lorsque l’ajout de capteurs est difficile, mais les données d’entraînement et la disponibilité effective des ressources restent des composantes du coût.
La décision doit partir du défaut à corriger : mauvaise localisation spatiale, perte de détails géométriques, changements de distribution ou exécution des contacts. Mesurer d’abord ce défaut, puis choisir le capteur et la représentation qui permettent de l’atténuer.
Pour approfondir et références
- DP3 — full paper, Tables I and IV (RSS 2024)
- 3D Diffuser Actor — full paper, Table 3 and real-world evaluation (CoRL 2024)
- RVT-2 — full paper, Tables I–III (RSS 2024)
- Generalizable Humanoid Manipulation with 3D Diffusion Policies — v3, Tables II and IV
- GeoAlign — full paper v2, Table 1 and geometry post-training (2026)
- RISE — full paper, methods and deployment discussion (IROS 2024)
- DP3 — official code and data
- RVT and RVT-2 — official implementation and models
- RISE — official deployment guide and license
- nvblox — core library interface: depth, pose and obstacle-distance mapping
- HomeRobot: Open-Vocabulary Mobile Manipulation (CoRL 2023)
- Tuning depth cameras for best performance
- GeoAlign — official project and code-release status
Les synthèses présentent les affirmations des auteurs et notre analyse. La popularité n’est pas une validation : consultez les publications originales pour les méthodes, résultats et limites.