Cámaras de profundidad y posición 3D en el aprendizaje robótico: evidencia y práctica
Qué revelan DP3, RVT-2, 3D Diffuser Actor y las políticas espaciales más recientes sobre profundidad, estado del robot y generalización, y cómo evaluarlas en un sistema real.
1902 palabrasUnos 9 min de lectura
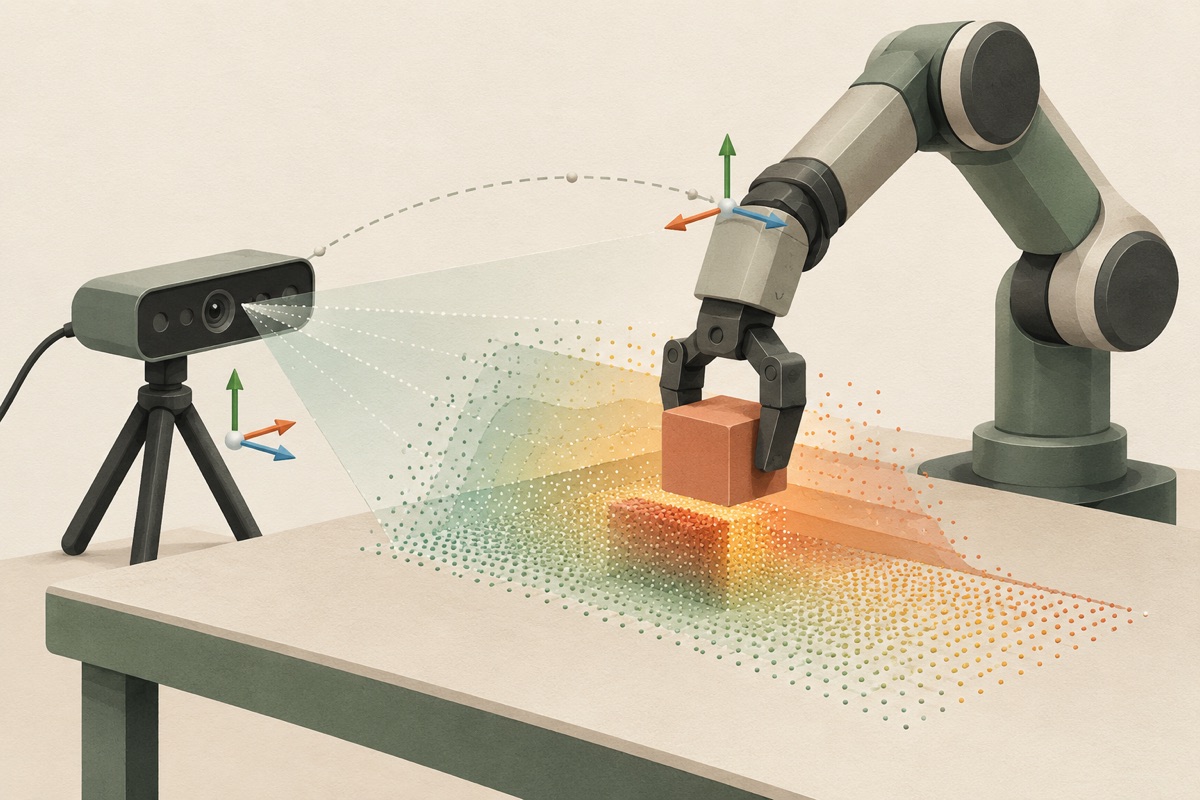
Las cámaras de profundidad pueden mejorar las políticas de control de los robots al facilitar la representación de las distancias y las relaciones espaciales. La evidencia más sólida corresponde a una cadena completa: geometría medida o aprendida, sistemas de coordenadas coherentes, un modelo adecuado y un controlador capaz de ejecutar sus predicciones. Añadir un canal de profundidad, por sí solo, no es una mejora fiable.
Este artículo de investigación examina trabajos representativos de 2023–2026 y recursos de implementación consultados el 30 de octubre de 2026. Los resultados que se presentan son los publicados por sus autores, no reproducciones de Dentry. La selección es una guía de lectura centrada en el tema, no una revisión sistemática ni una clasificación entre distintos bancos de pruebas.
Qué significa «información de posición»
Bajo una misma etiqueta suelen agruparse varias señales diferentes:
- Geometría de la escena: un mapa de profundidad proporciona la profundidad de cada píxel; un modelo de cámara calibrado convierte los píxeles y su profundidad en puntos tridimensionales.
- Transformaciones entre sistemas de coordenadas: la pose de la cámara relaciona esos puntos con la base del robot o con un mapa. La transformación de una cámara montada en la muñeca cambia cuando se mueve el brazo.
- Estado del robot: las posiciones articulares, la apertura de la pinza o la pose actual del efector final describen al propio robot. Cada política utiliza un subconjunto diferente de estas señales.
- Codificación de posición del modelo: las coordenadas o los desplazamientos relativos indican a un modelo de atención cómo se relacionan las características de la escena y las acciones candidatas. Es una elección de representación, no otro sensor.
Nuestra interpretación es que mantener explícitas estas distinciones facilita el diagnóstico de los experimentos: una imagen de profundidad precisa no puede compensar una transformación incorrecta entre la cámara y el robot.
DP3: una nube de puntos ayuda más que un canal de imagen adicional
En la comparación de DP3 sobre 72 tareas de simulación, la tasa media de éxito es del 74,4 %, frente al 59,8 % de Diffusion Policy con imágenes RGB: una diferencia de 14,6 puntos porcentuales calculada a partir de los valores redondeados publicados. DP3 condiciona su generador de acciones con una representación compacta de la nube de puntos y las poses del robot. [1]
Su estudio de ablación de las representaciones sobre seis tareas resulta especialmente informativo: las nubes de puntos alcanzan el 78,3 %, las imágenes RGB el 40,7 %, las imágenes de profundidad el 32,0 % y las imágenes RGB-D el 34,7 %. Añadir profundidad a una entrada basada en imágenes no reprodujo el resultado de la nube de puntos. También cambian los codificadores, por lo que el experimento evalúa la cadena de representación, en lugar de aislar el efecto causal de un sensor. [1]
Para un equipo de desarrollo de software, la pregunta útil es cómo se conserva la geometría durante el preprocesamiento y la codificación. El repositorio oficial de DP3 ofrece código y enlaces a los datos para investigar esa cuestión. [7]
3D Diffuser Actor: la posición relativa también importa
En la ablación sobre RLBench que presenta el artículo, una variante 2D alcanza el 47,0 %, una variante 3D con atención absoluta el 71,3 % y el modelo completo el 81,3 %. El modelo completo mejora a esas variantes en 34,3 y 10,0 puntos porcentuales, respectivamente. La variante 2D también agrega las características dentro de cada vista, así que estos resultados aportan evidencia sobre la representación y la fusión conjuntamente. [2]
Las características de la escena, la ubicación actual del efector final y las acciones candidatas interactúan en una representación espacial compartida. En la configuración con el robot real, un planificador de movimiento ejecuta las poses predichas. Es una separación útil entre aprender un objetivo y conseguir que el robot lo alcance. [2]
RVT-2: la colocación precisa necesita detalle geométrico local
RVT-2 refina un objetivo aproximado mediante una vista virtual más cercana de la región pertinente de la nube de puntos. Su resultado en RLBench es del 81,4 %, frente al 62,9 % de RVT. Ambos ya utilizan observaciones tridimensionales; la diferencia de 18,5 puntos no es una comparación entre una cámara de profundidad y una cámara RGB. [3]
En tres tareas reales de precisión, entre ellas la inserción de un pasador y de un conector, la media publicada aumenta del 33,3 % al 53,3 %. Cada tarea dispone de solo diez demostraciones y diez ensayos de evaluación. Esos resultados respaldan un prototipo de investigación, no la afirmación de que la inserción esté lista para producción. Los autores también plantean la realimentación de fuerza como vía para abordar los errores de contacto restantes. El código y los modelos están disponibles en el repositorio oficial de RVT. [3] [8]
La generalización puede mejorar sin que lo hagan los resultados en tareas conocidas
El artículo de iDP3 aporta un matiz importante. En una prueba de recogida y colocación en una escena nueva, iDP3 tiene éxito en 9 de 10 ensayos, frente a 2 de 10 para Diffusion Policy con imágenes RGB y un codificador R3M ajustado mediante entrenamiento adicional. Sin embargo, la referencia RGB obtiene mejores resultados en un experimento distinto, realizado en las condiciones de entrenamiento con pocos datos. Esos experimentos utilizan protocolos de evaluación diferentes y no deben combinarse en una única tasa de éxito destacada. [4]
iDP3 utiliza geometría en el sistema de coordenadas de la cámara, obtenida con una cámara de profundidad LiDAR RealSense L515 montada en la cabeza, y la combina con posiciones articulares. En la configuración de manipulación humanoide demostrada, la parte inferior del cuerpo está apoyada y permanece inmóvil; estos resultados no demuestran marcha autónoma ni capacidad para prestar servicios domésticos. La lección práctica es evaluar los cambios de escena por separado de la precisión en tareas conocidas. [4]
GeoAlign: la profundidad puede ser útil durante el entrenamiento sin una cámara de profundidad en la ejecución
GeoAlign, un estudio de 2026, utiliza supervisión RGB-D en una fase de postentrenamiento geométrico. Durante la ejecución, su política recibe imágenes RGB, lenguaje y el estado del robot, sin mapas de profundidad medidos ni predichos como entradas. Esto lo convierte en una opción de despliegue distinta de las políticas basadas en nubes de puntos, que necesitan observaciones de profundidad en cada paso. [5]
En ocho tareas reales con ALOHA y 160 ensayos, la referencia que utiliza solo RGB tiene éxito 104 veces, es decir, un 65,0 %; GeoAlign tiene éxito 126 veces, que los autores expresan como un 78,8 %. La diferencia es de aproximadamente 13,8 puntos porcentuales. El sistema también utiliza un conjunto de datos de postentrenamiento geométrico con 580 960 pares de fotogramas RGB-D, por lo que la mejora no puede atribuirse únicamente a la arquitectura. En la revisión realizada para este artículo, el proyecto todavía anunciaba que el código estaría disponible próximamente. [5] [13]
Es una línea de investigación para equipos que ya cuentan con conjuntos de datos robóticos RGB. Aún no es un sustituto listo para instalar de una política disponible basada en profundidad.
RISE: el hardware y la recopilación de datos cambian el resultado
RISE utiliza una nube de puntos de una sola vista y predice acciones en el sistema de coordenadas de la cámara; su política no añade entradas propioceptivas separadas. En su discusión práctica, los autores describen dificultades para reproducir DP3 con su propia cámara y su configuración de demostraciones. El ruido de profundidad, las decisiones sobre el espacio de trabajo y las trayectorias de demostración influyen en la transferencia. [6]
Su repositorio oficial proporciona instrucciones de calibración y evaluación con robots reales. El código y los datos se ofrecen bajo la licencia CC BY-NC-SA 4.0, de modo que el uso comercial exige comprobar los permisos aplicables, en lugar de asumir que cualquier repositorio público de investigación lo permite. [9]
Aplicaciones más allá de la política aprendida
En la manipulación sobre una mesa, las aplicaciones más directas son localizar objetivos de agarre, mover objetos a ubicaciones especificadas en el espacio y afinar la colocación cerca de un alojamiento o un recipiente. Los estudios anteriores demuestran ejemplos de estas capacidades, con robots y condiciones de evaluación diferentes.
La navegación puede beneficiarse sin volver a entrenar un gran modelo de acción. nvblox de NVIDIA recibe observaciones de profundidad, parámetros de la cámara y una transformación de pose, integra un mapa tridimensional y obtiene información sobre la distancia a los obstáculos para planificar trayectorias. Es un componente de geometría y planificación, no una prueba de que un modelo de lenguaje se vuelva más capaz por el mero hecho de recibir profundidad. [10]
HomeRobot ilustra el problema de integración más amplio: su banco de pruebas de manipulación móvil con vocabulario abierto combina la búsqueda de objetos, la navegación, el agarre y la colocación. Sus referencias originales en el mundo real alcanzaron un 20 % de éxito. Es un resultado histórico del sistema, no un límite actual ni una ablación que aísle la profundidad. [11]
Un plan práctico de evaluación
Lo que sigue es nuestra propuesta de metodología de ingeniería, no un experimento ya realizado por Dentry.
- Elegir una tarea acotada. Empezar por recoger y colocar objetos sobre una superficie de trabajo fija, y definir el éxito antes de recopilar demostraciones. Registrar el grado de finalización parcial por separado del éxito de la tarea completa.
- Establecer una referencia geométrica utilizable. Comprobar la profundidad a las distancias reales de trabajo y sobre los materiales que se van a utilizar. Inspeccionar los píxeles ausentes, la alineación entre RGB y profundidad, las marcas de tiempo, los parámetros intrínsecos de la cámara y la transformación entre la cámara y el robot. Las recomendaciones de ajuste del fabricante son un punto de partida útil, no un sustituto de las mediciones en la instalación. [12]
- Registrar observaciones y acciones sincronizadas. Conservar RGB sin procesar, profundidad, calibración, estado del robot y marcas de tiempo. Explicitar el sistema de coordenadas y las unidades; un objetivo expresado en el sistema de la cámara no es intercambiable con otro expresado en el de la base del robot.
- Comparar variantes controladas. Utilizar las mismas demostraciones, presupuesto de entrenamiento, distribución de tareas y controlador siempre que sea posible. Comparar RGB más estado, RGB-D más estado y una representación en nube de puntos más estado. Indicar con claridad si también cambia un codificador o un modelo preentrenado.
- Probar los cambios relevantes fuera del conjunto de entrenamiento. Mover los objetos, cambiar fondos e iluminación, modificar el punto de vista, introducir oclusiones y evaluar distintos ejemplares de los objetos. Para la inserción o la manipulación con control de compliancia, evaluar la estrategia de control del contacto además de la localización visual.
- Medir el ciclo completo. Informar del éxito de las tareas completas con el número de ensayos y la incertidumbre, el error de colocación, las intervenciones, las colisiones, la latencia de inferencia y el tiempo hasta completar la tarea. Mantener los límites de movimiento, la comprobación de colisiones y la parada de emergencia en la capa de ejecución.
Un candidato útil para un primer despliegue es una política reproducible de manipulación sobre mesa con una cadena RGB-D calibrada y un controlador existente. Una plataforma móvil puede obtener valor inmediato de un mapa basado en profundidad. Conviene seguir las alternativas que solo utilizan RGB durante la ejecución, como GeoAlign, cuando sea difícil añadir sensores, pero los datos de entrenamiento y la disponibilidad de las implementaciones siguen formando parte del coste.
La decisión debe partir del fallo que se quiere resolver: localización espacial deficiente, pérdida de detalle geométrico, cambios de distribución o ejecución del contacto. Primero hay que medir ese fallo y después seleccionar el sensor y la representación que lo reduzcan.
Lecturas y referencias
- DP3 — full paper, Tables I and IV (RSS 2024)
- 3D Diffuser Actor — full paper, Table 3 and real-world evaluation (CoRL 2024)
- RVT-2 — full paper, Tables I–III (RSS 2024)
- Generalizable Humanoid Manipulation with 3D Diffusion Policies — v3, Tables II and IV
- GeoAlign — full paper v2, Table 1 and geometry post-training (2026)
- RISE — full paper, methods and deployment discussion (IROS 2024)
- DP3 — official code and data
- RVT and RVT-2 — official implementation and models
- RISE — official deployment guide and license
- nvblox — core library interface: depth, pose and obstacle-distance mapping
- HomeRobot: Open-Vocabulary Mobile Manipulation (CoRL 2023)
- Tuning depth cameras for best performance
- GeoAlign — official project and code-release status
Los resúmenes presentan las afirmaciones de los autores y nuestro análisis. La popularidad no valida los resultados; consulta los originales para conocer métodos, resultados y limitaciones.