深度カメラと3次元位置情報はロボット学習をどう改善するか:研究と実践
DP3、RVT-2、3D Diffuser Actor、近年の空間認識型方策から、深度・ロボット状態・汎化性能の関係を読み解き、実機システムでの評価方法を考えます。
4,266 文字読了まで約 11 分
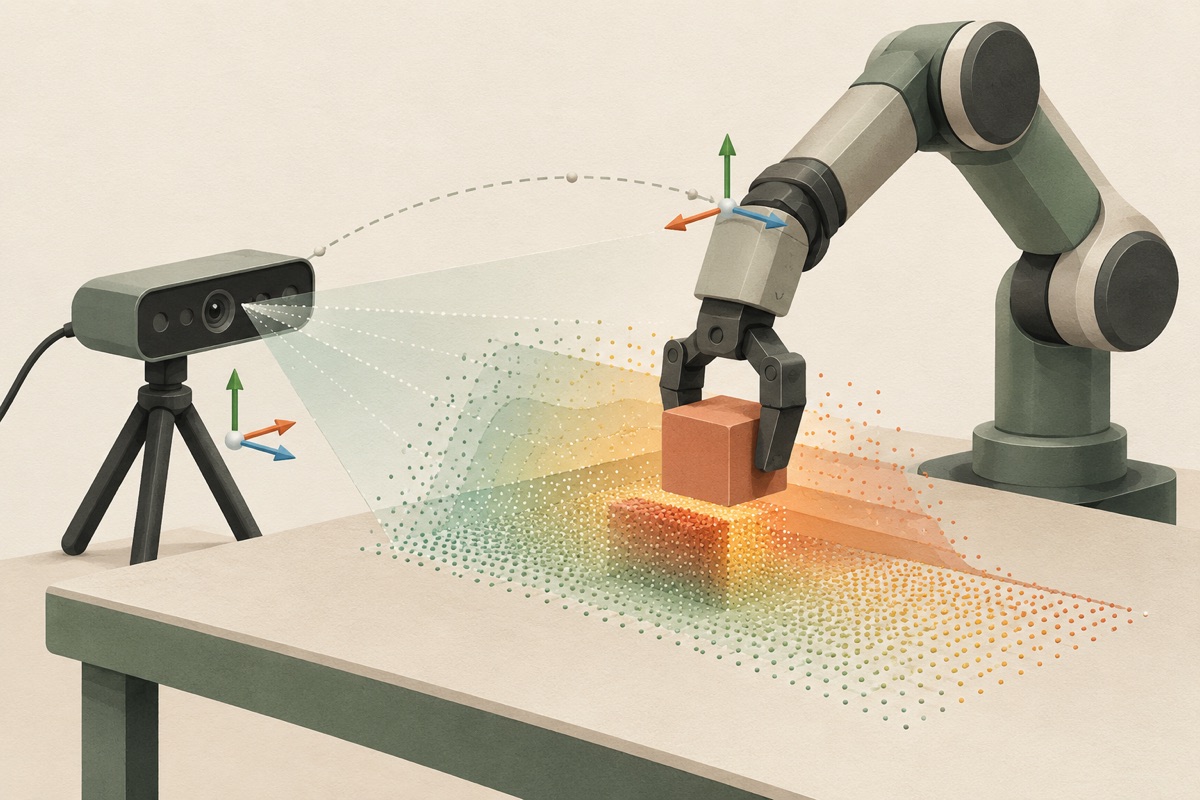
深度カメラは、距離や空間的な関係を表現しやすくすることで、ロボットの行動方策を改善できる可能性があります。ただし、有力な研究結果が示しているのは、計測または学習された幾何情報、一貫した座標系、適切なモデル、そして予測を実行できる制御器を組み合わせた処理系全体の効果です。深度チャネルを追加するだけでは、確実な性能向上は期待できません。
この研究特集では、2023〜2026年の代表的な論文と、2026年10月30日に確認した実装資料を取り上げます。以下の結果は著者らの報告であり、Dentryによる追試ではありません。文献の選定は対象を絞った読書ガイドであり、体系的レビューでも、異なるベンチマークを横断する順位付けでもありません。
「位置情報」は何を意味するのか
一つの言葉に、性質の異なる複数の信号がまとめられがちです。
- シーンの幾何情報:深度マップは画素ごとの奥行きを示します。校正済みのカメラモデルを使うと、画素と深度を3次元の点に変換できます。
- 座標変換:カメラの姿勢と位置を使い、その点をロボットのベース座標系や地図座標系に対応付けます。手首に取り付けたカメラの変換は、アームの動きに伴って変わります。
- ロボット状態:関節位置、グリッパーの開き具合、現在のエンドエフェクター姿勢など、ロボット自身の状態を表します。どの情報を使うかは方策によって異なります。
- モデルの位置エンコーディング:座標や相対変位により、シーン特徴と行動候補の関係を注意機構に伝えます。これは表現方式の選択であり、別のセンサーではありません。
私たちは、これらを明確に区別することで、実験結果の原因を調べやすくなると考えます。深度画像が正確でも、カメラからロボットへの座標変換が間違っていれば、その誤りは補えません。
DP3:画像チャネルの追加以上に点群表現が役立つ
DP3の72タスクのシミュレーション比較では、平均成功率は74.4%でした。RGBを使うDiffusion Policyの59.8%と比べると、公表された丸め後の値で14.6パーセントポイントの差があります。DP3は、コンパクトな点群表現とロボットの姿勢情報を条件として行動を生成します。[1]
特に参考になるのが、6タスクを使った表現方式のアブレーション実験です。成功率は点群で78.3%、RGBで40.7%、深度画像で32.0%、RGB-D画像で34.7%でした。画像入力に深度を加えるだけでは、点群表現の結果を再現できませんでした。エンコーダーも異なるため、これはセンサー単体の因果的な効果を切り分けた実験ではなく、表現を作る処理系の比較です。[1]
ソフトウェア開発チームにとって有益な問いは、前処理と符号化を経ても幾何情報がどれだけ保たれるか、という点です。DP3の公式リポジトリには、その検証に利用できるコードとデータへのリンクがあります。[7]
3D Diffuser Actor:相対位置も重要になる
論文中のRLBenchアブレーション実験では、2D版の成功率は47.0%、絶対位置に基づく注意機構を使う3D版は71.3%、完全版は81.3%でした。完全版はそれぞれを34.3、10.0パーセントポイント上回っています。ただし2D版では、各視点内の特徴をプーリングする処理も採用しているため、表現と情報融合の組み合わせに関する証拠として読む必要があります。[2]
シーン特徴、現在のエンドエフェクター位置、行動候補は、共通の空間表現の中で相互に関係付けられます。実機の構成では、予測された姿勢への移動をモーションプランナーが実行します。目標を学習する部分と、その目標にロボットを到達させる部分を分ける、有用な設計例です。[2]
RVT-2:精密な配置には局所的な幾何の詳細が必要
RVT-2は、関係する点群領域をより近くから見た仮想視点を使い、粗く推定した目標を精密化します。RLBenchでの成功率は81.4%で、RVTの62.9%を上回りました。両者とも既に3次元の観測を使っているため、この18.5パーセントポイントの差は、深度カメラとRGBカメラを比較した結果ではありません。[3]
ペグやプラグの挿入を含む3種類の実機精密作業では、報告された平均成功率が33.3%から53.3%へ上昇しました。各タスクのデモンストレーションは10件、評価試行も10回に限られます。研究用プロトタイプの可能性を示す結果であり、生産現場ですぐに使える挿入性能を意味するものではありません。著者らは、残る接触時の誤差に対応する方法として力フィードバックにも言及しています。公式RVTリポジトリではコードとモデルが公開されています。[3] [8]
既知のタスクで改善しなくても、汎化が向上する場合がある
iDP3の論文は、重要な留保を与えています。新しいシーンでのピックアンドプレース試験では、iDP3は10回中9回成功し、ファインチューニング済みのR3Mエンコーダーを使うRGB Diffusion Policyは10回中2回でした。一方、少量のデータを使い、学習時の設定で評価した別の実験では、RGBのベースラインの方が高い性能を示しました。評価手順が異なるため、一つの代表成功率にまとめてはいけません。[4]
iDP3は、頭部に搭載したRealSense L515 LiDAR深度カメラから得た幾何情報をカメラ座標系で表し、関節位置と組み合わせて使います。実演されたヒューマノイドの操作構成では、下半身は支持され、静止しています。これらの結果から、自律歩行や家庭内サービスまで実証されたとはいえません。実践上の教訓は、シーンが変わったときの性能と、既知のタスクでの精度を分けて試験することです。[4]
GeoAlign:実行時に深度カメラがなくても、学習時の深度を活用できる
2026年の研究であるGeoAlignは、幾何表現の追加学習にRGB-Dによる教師信号を使います。実行時の方策への入力はRGB、言語、ロボット状態であり、実測または予測された深度マップは入力しません。毎ステップ深度観測を必要とする点群ベースの方策とは、異なる導入方法になります。[5]
実機ALOHAでの8タスク、合計160回の試行では、報告されたRGBのみのベースラインは104回成功し、成功率は65.0%でした。GeoAlignは126回成功し、78.8%と報告されています。差は約13.8パーセントポイントです。ただし、このシステムは追加で、580,960対のRGB-Dフレームを含む幾何表現の追加学習用データセットを使用しているため、改善をアーキテクチャだけの効果とすることはできません。本記事の確認時点では、プロジェクトはコードを近日公開予定としています。[5] [13]
既存のRGBロボットデータセットを持つチームにとって、検討に値する研究の方向性です。ただし、既に利用可能な深度ベースの方策を、そのままインストールして置き換えられる段階にはありません。
RISE:ハードウェアとデータ収集が結果を左右する
RISEは単一視点の点群を使い、カメラ座標系で行動を予測します。方策には別途、ロボット自身の状態を表す本体感覚入力を加えません。論文の実践面の議論では、著者らのカメラとデモンストレーションの構成でDP3を再現する難しさが報告されています。深度ノイズ、作業空間の設定、デモンストレーションの軌道は、いずれも別の環境への適用に影響します。[6]
公式リポジトリには、校正と実機評価の手引きがあります。コードとデータのライセンスはCC BY-NC-SA 4.0です。公開された研究リポジトリなら何でも商用利用できると考えず、商用利用に必要な許諾を確認する必要があります。[9]
学習された方策以外での応用
卓上操作での直接的な用途には、把持対象の位置特定、空間的に指定された場所への物体移動、ソケットや受け容器の近くでの配置の精密化があります。上記の研究では、異なるロボットと評価条件の下で、これらの能力の例が示されています。
ナビゲーションでは、大規模な行動モデルを再学習しなくても効果を得られます。NVIDIAのnvbloxは、深度観測、カメラパラメーター、姿勢変換を入力として3次元地図を統合し、経路計画に用いる障害物までの距離情報を算出します。これは幾何処理と計画のための構成要素であり、言語モデルに深度を渡すだけで能力が高まることを示す証拠ではありません。[10]
HomeRobotは、より広いシステム統合の課題を示しています。オープンボキャブラリー型の移動マニピュレーションを評価するベンチマークで、物体の発見、移動、把持、配置を組み合わせています。当初の実機ベースラインの成功率は20%でした。これは過去のシステム全体の結果であり、現在の性能の上限でも、深度だけの効果を切り分けた実験でもありません。[11]
実践的な評価計画
以下は、Dentryが既に実施した実験ではなく、私たちが提案する開発・評価の進め方です。
- 対象を限定したタスクを選びます。固定した作業面でのピックアンドプレースから始め、デモンストレーションを集める前に成功条件を定めます。部分的な達成は、タスク全体の成功と分けて記録します。
- 使用に耐える幾何計測の基準を整えます。実際の作動距離と対象の材質で深度を確認し、欠損画素、RGBと深度の位置合わせ、タイムスタンプ、カメラ内部パラメーター、カメラからロボットへの座標変換を調べます。メーカーの調整資料は出発点として役立ちますが、設置したシステムの実測には代えられません。[12]
- 同期した観測と行動を記録します。生のRGB、深度、校正情報、ロボット状態、タイムスタンプを保存します。座標系と単位を明示してください。カメラ座標系の目標とロボットのベース座標系の目標は、そのまま交換できません。
- 条件をそろえた構成を比較します。可能な限り、デモンストレーション、学習計算量、タスク分布、制御器を共通にします。「RGB+状態」「RGB-D+状態」「点群表現+状態」を比べ、エンコーダーや事前学習モデルも変わる場合は、その点を明記します。
- 学習データの外で重要となる変化を試します。物体を移動し、背景や照明、視点を変え、遮蔽を加え、異なる物体個体でも評価します。挿入や柔軟な接触を伴う操作では、視覚による位置推定だけでなく、接触時の制御方法も試験します。
- 処理ループ全体を測定します。タスク全体の成功率に試行回数と不確かさを添え、配置誤差、介入、衝突、推論遅延、完了までの時間も報告します。動作制限、衝突チェック、非常停止は実行層に組み込みます。
最初の導入候補として有用なのは、校正済みのRGB-D処理系と既存の制御器を組み合わせた、再現可能な卓上操作方策です。一方、移動ロボットでは、深度を使う地図から、より早く価値を得られる可能性があります。センサーを追加しにくい場合には、GeoAlignのように実行時はRGBのみで動く手法にも注目する価値がありますが、学習データや公開状況も導入コストの一部です。
選択の基準となるのは、改善したい失敗の種類です。空間的な位置推定の不足なのか、幾何の詳細が処理中に失われているのか、データ分布の変化なのか、接触動作の実行なのか。まずその失敗を測り、改善につながるセンサーと表現方式を選ぶべきです。
参考文献・関連資料
- DP3 — full paper, Tables I and IV (RSS 2024)
- 3D Diffuser Actor — full paper, Table 3 and real-world evaluation (CoRL 2024)
- RVT-2 — full paper, Tables I–III (RSS 2024)
- Generalizable Humanoid Manipulation with 3D Diffusion Policies — v3, Tables II and IV
- GeoAlign — full paper v2, Table 1 and geometry post-training (2026)
- RISE — full paper, methods and deployment discussion (IROS 2024)
- DP3 — official code and data
- RVT and RVT-2 — official implementation and models
- RISE — official deployment guide and license
- nvblox — core library interface: depth, pose and obstacle-distance mapping
- HomeRobot: Open-Vocabulary Mobile Manipulation (CoRL 2023)
- Tuning depth cameras for best performance
- GeoAlign — official project and code-release status
研究解説では著者の主張と私たちの分析を紹介します。人気は検証の代わりにはなりません。手法、結果、限界については原論文をご確認ください。