深度相机与三维位置信息如何改善机器人模型:研究证据与应用实践
从 DP3、RVT-2、3D Diffuser Actor 到 GeoAlign,梳理深度、机器人状态与空间表示的作用,区分可核实的性能提升和真实部署条件。
2,912 字预计阅读 7 分钟
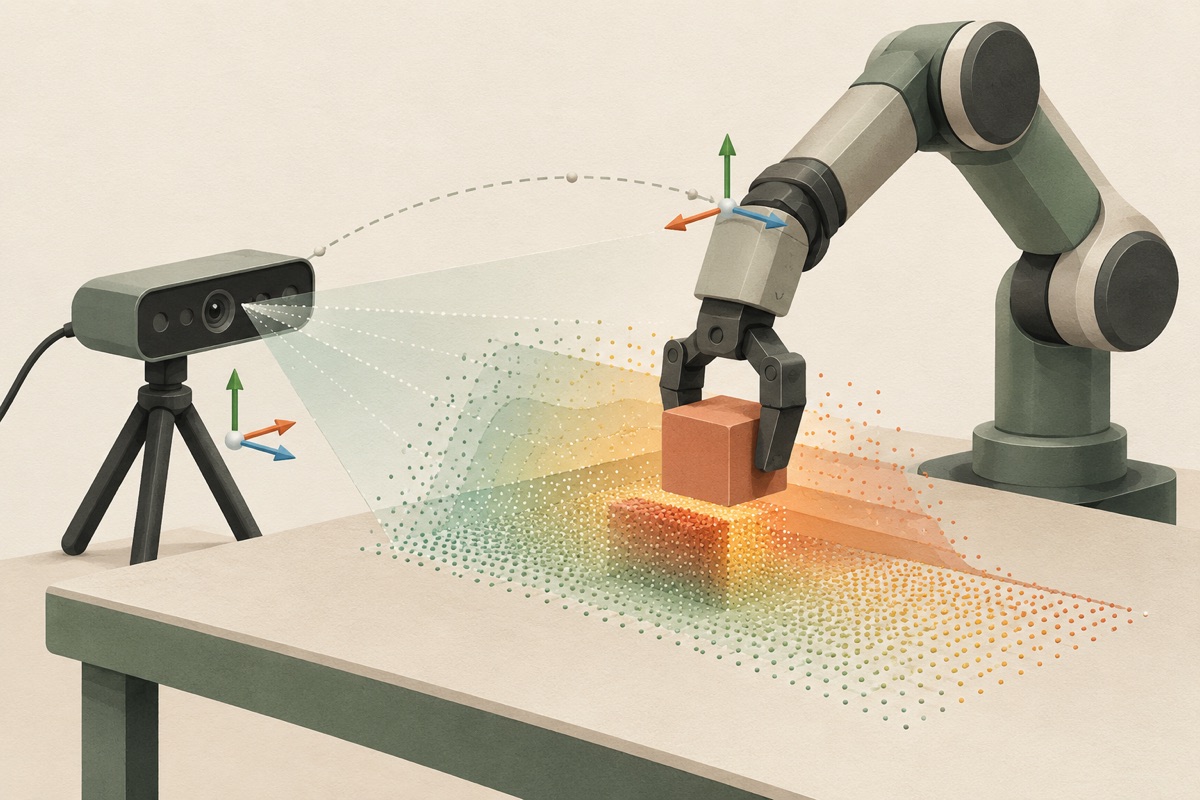
深度相机能够让机器人策略更容易表示距离和空间关系,从而改善表现。但现有证据支持的是一套完整流程:实测或学习得到的几何信息、一致的坐标系、合适的模型,以及能够执行预测结果的控制器。单纯增加一个深度通道,并不能保证升级有效。
本文梳理 2023—2026 年的代表性论文及实现资料,来源核对截至 2026 年 10 月 30 日。以下结果均来自作者报告,Dentry 没有进行独立复现。这是一份围绕具体问题组织的阅读指南,不是系统性综述,也不是跨基准的模型排名。
“位置信息”包含哪些不同信号
讨论机器人模型时,几种不同的信息经常被放在同一个名称下:
- 场景几何:深度图提供逐像素的深度,结合标定后的相机模型,可以将像素和深度转换为三维点。
- 坐标变换:相机位姿把这些点与机器人基座坐标系或地图联系起来。腕部相机的坐标变换会随着机械臂运动而改变。
- 机器人自身状态:关节位置、夹爪开合或当前末端执行器位姿,描述的是机器人自己。不同策略使用的状态子集并不相同。
- 模型的位置编码:坐标或相对位移让注意力模型知道场景特征与候选动作之间的关系。这属于表示方式,不是另一种传感器。
我们的分析是,先区分这些信号,才能更准确地定位实验问题:即使深度图很准确,也无法补偿错误的相机到机器人坐标变换。
DP3:点云表示比增加一个图像通道更值得关注
DP3 在 72 个仿真任务中的平均成功率为 74.4%,RGB Diffusion Policy 为 59.8%。按论文给出的四舍五入数值计算,相差 14.6 个百分点。DP3 用紧凑的点云表示和机器人位姿作为动作生成器的条件。[1]
六任务表示消融更能说明问题:点云达到 78.3%,RGB 图像为 40.7%,深度图为 32.0%,RGB-D 图像为 34.7%。在图像输入中直接增加深度,并没有复现点云方案的结果。不过,不同表示使用的编码器也不同,因此这检验的是表示流程,而不是隔离传感器这一变量的因果实验。[1]
对软件团队而言,关键问题是几何信息在预处理和编码过程中如何被保留。DP3 官方仓库提供了代码和数据入口,可作为研究这个问题的起点。[7]
3D Diffuser Actor:相对位置同样重要
在论文的 RLBench 消融实验中,二维版本达到 47.0%,采用绝对位置注意力的三维版本为 71.3%,完整模型为 81.3%。完整模型分别高出 34.3 和 10.0 个百分点。二维版本还对每个视角内的特征进行了池化,因此这里的证据同时涉及空间表示和特征融合方式。[2]
场景特征、当前末端执行器位置,以及候选动作,在共同的空间表示中交互。在真实机器人设置中,预测位姿由运动规划器负责执行。这种做法把“学习应该到哪里”与“让机器人实际到达那里”分开,具有实践参考价值。[2]
RVT-2:精确放置需要局部几何细节
RVT-2 先找到粗略目标,再通过相关点云区域的近距离虚拟视图细化定位。其 RLBench 成功率为 81.4%,RVT 为 62.9%。两者都已使用三维观察,因此 18.5 个百分点的差值并不是深度相机与 RGB 相机的比较。[3]
在包含插销和插头插入的三项真实精密任务中,论文报告的平均成功率从 33.3% 上升到 53.3%。每项任务只有十条示范和十次评估。这些结果支持研究原型的价值,不能据此认定插接已经达到生产环境的可靠性要求。作者也讨论了用力反馈处理剩余接触误差的可能性。官方 RVT 仓库提供代码和模型。[3] [8]
泛化能力更好,不等于熟悉任务的表现也更好
iDP3 提供了一个重要的限定条件。在新场景拿放测试中,iDP3 十次成功九次,采用微调 R3M 编码器的 RGB Diffusion Policy 十次成功两次。但在另一组小数据训练设置实验中,RGB 基线表现更好。两组实验的评估协议不同,不能把它们合并成一个醒目的成功率。[4]
iDP3 将头部 RealSense L515 激光雷达深度相机提供的相机坐标系几何信息,与关节位置结合。其展示的人形机器人操作平台,下肢有支撑并保持静止;这些结果没有证明机器人已经能够自主行走并完成家庭服务。实际评估应把场景变化带来的泛化能力,与熟悉任务上的准确率分开考察。[4]
GeoAlign:深度可以用于训练,而不必成为运行时的相机输入
2026 年的 GeoAlign 在几何后训练阶段使用 RGB-D 监督。执行时,策略接收 RGB、语言和机器人状态,不将实测或预测的深度图作为策略输入。这与每一步都需要深度观察的点云策略,形成了不同的部署选择。[5]
在八项真实 ALOHA 任务、共 160 次测试中,RGB-only 基线成功 104 次,即 65.0%;GeoAlign 成功 126 次,论文报告为 78.8%,差值约为 13.8 个百分点。但这个系统还额外使用了一个包含 580,960 对 RGB-D 帧的几何后训练数据集,因此不能把提升全部归因于架构。本文核对时,项目仍将代码标为即将发布。[5] [13]
对于已有 RGB 机器人数据集的团队,这是一条值得关注的研究方向,目前还不能将它当成可直接安装、替换已有深度策略的方案。
RISE:硬件与示教方式会改变结果
RISE 使用单视角点云,在相机坐标系中预测动作;其策略没有额外加入独立的本体感知输入。作者在实践讨论中报告,在自己的相机和示教设置下,难以复现 DP3 的效果。深度噪声、工作空间设置和示教轨迹都会影响迁移表现。[6]
官方仓库提供标定与真实机器人评估指南。代码和数据采用 CC BY-NC-SA 4.0 许可,商业使用前需要确认相应授权,不能把所有公开研究仓库都视为允许商业使用。[9]
除了学习策略,还能用在哪里
对桌面操作而言,直接的用途包括定位抓取目标、把物体移到指定空间位置,以及在插口或容器附近细化放置动作。上述研究展示了这些能力的不同实例,但机器人平台和评估条件各不相同。
导航也可以从深度信息中获益,不一定要重新训练大型动作模型。NVIDIA 的 nvblox 接收深度观察、相机参数和位姿变换,融合三维地图,并生成路径规划所需的障碍物距离信息。它属于几何与规划组件,不能作为“语言模型只要接入深度就会更强”的证据。[10]
HomeRobot 展示了更完整的集成难题:其开放词汇移动操作基准同时涉及寻找物体、导航、抓取和放置。最初的真实环境基线成功率为 20%。这是一个历史系统结果,不是今天的能力上限,也不是单独比较深度作用的消融实验。[11]
怎样做一轮有用的工程验证
以下是我们提出的工程流程,并不是 Dentry 已经实施过的实验。
- 先选一个边界明确的任务。可以从固定工作台上的拿放开始,在采集示范前定义成功条件。部分完成与完整任务成功应分别记录。
- 建立可用的几何基线。在实际工作距离和实际物体材质上检查深度,查看缺失像素、RGB 与深度对齐、时间戳、相机内参,以及相机到机器人的坐标变换。厂商调优指南可以作为起点,但不能代替对实际安装结果的测量。[12]
- 同步记录观察与动作。保存原始 RGB、深度、标定、机器人状态和时间戳,明确坐标系及单位。相机坐标系中的目标,不能直接当作机器人基座坐标系中的目标。
- 比较受控的不同方案。尽可能使用相同示范、训练预算、任务分布和控制器,比较“RGB 加状态”“RGB-D 加状态”“点云表示加状态”。如果编码器或预训练模型也变了,要明确说明。
- 测试训练集以外、确实影响应用的变化。移动物体,更换背景和光照,改变视角,引入遮挡,并评估不同物体实例。插接或柔顺操作还应测试接触控制策略,而不只是视觉定位。
- 测量完整执行过程。报告完整任务成功率、测试次数和不确定性,以及放置误差、人工干预、碰撞、推理延迟和任务耗时。运动限制、碰撞检查和急停应保留在执行层。
一个可行的首轮部署候选,是带有标定 RGB-D 流程、能够复现的桌面策略,再配合已有控制器。移动平台则可能先从深度地图中获得直接收益。如果难以增加传感器,可以关注 GeoAlign 这类运行时仅用 RGB 的方法,但训练数据和代码发布状态同样属于使用成本。
最终应根据要解决的失败类型作选择:空间定位不准、几何细节在编码中丢失、环境分布变化,还是接触执行失败。先测量具体问题,再选择能够改善它的传感器和表示方式。
延伸阅读与参考资料
- DP3 — full paper, Tables I and IV (RSS 2024)
- 3D Diffuser Actor — full paper, Table 3 and real-world evaluation (CoRL 2024)
- RVT-2 — full paper, Tables I–III (RSS 2024)
- Generalizable Humanoid Manipulation with 3D Diffusion Policies — v3, Tables II and IV
- GeoAlign — full paper v2, Table 1 and geometry post-training (2026)
- RISE — full paper, methods and deployment discussion (IROS 2024)
- DP3 — official code and data
- RVT and RVT-2 — official implementation and models
- RISE — official deployment guide and license
- nvblox — core library interface: depth, pose and obstacle-distance mapping
- HomeRobot: Open-Vocabulary Mobile Manipulation (CoRL 2023)
- Tuning depth cameras for best performance
- GeoAlign — official project and code-release status
论文解读介绍作者的主张与我们的分析。社区热度不代表结果已获验证;请阅读原论文,了解方法、结果与局限。